import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (accuracy_score, precision_score, recall_score,
f1_score, confusion_matrix, ConfusionMatrixDisplay, classification_report)To demonstrate the classification metrics, a random forest model will be trained. Importing the libraries:
In [2]:
Making an imbalanced classification dataset.
In [4]:
X, y = make_classification(n_samples=1000, n_classes=3, n_informative=3,
                           weights=[0.1, 0.3, 0.6], random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Fitting the model.
In [6]:
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
Displaying the confusion matrix.
In [8]:
cm = confusion_matrix(y_test, y_pred)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=["Class 0", "Class 1", "Class 2"])
disp.plot(cmap="Blues")
plt.show()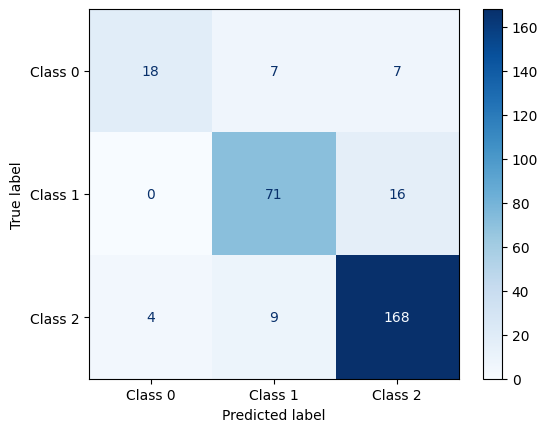
Printing the metrics.
In [10]:
report = classification_report(y_test, y_pred)

print(report)
precision recall f1-score support
0 0.82 0.56 0.67 32
1 0.82 0.82 0.82 87
2 0.88 0.93 0.90 181
accuracy 0.86 300
macro avg 0.84 0.77 0.80 300
weighted avg 0.85 0.86 0.85 300